https://gitcode.csdn.net/69e17f8554b52172bc6a7381.html
https://www.cuiliangblog.cn/detail/section/228479871
简单的快速入门学一下langChain
推荐测试api:硅基流动:https://cloud.siliconflow.cn/i/Pd9eOLa0 有一些免费模型可供使用
什么是LangChain?
LangChain是一个基于Python语言的模块化、可组合、面向开发者的开源框架,旨在简化基于大语言模型的应用程序开发。由Harrison Chase于2022年10月发起
langchain中lang是指language即LLM,Chain即链,也就是将LLM与外部数据和各种组件连接,构建成AI应用程序
LangChain能解决什么问题?
- 能够通过搜索技能获取新知识
- 能够进行外部操作、例如调用API、计算之类的
- 扩展记忆
Model大模型接口
Model介绍
一个AI应用的核心是它所依赖的LLM,langChain模型接口官方文档:
https://reference.langchain.com/python/langchain-core/language_models
Model分类:
langchain中llm分为以下几类:
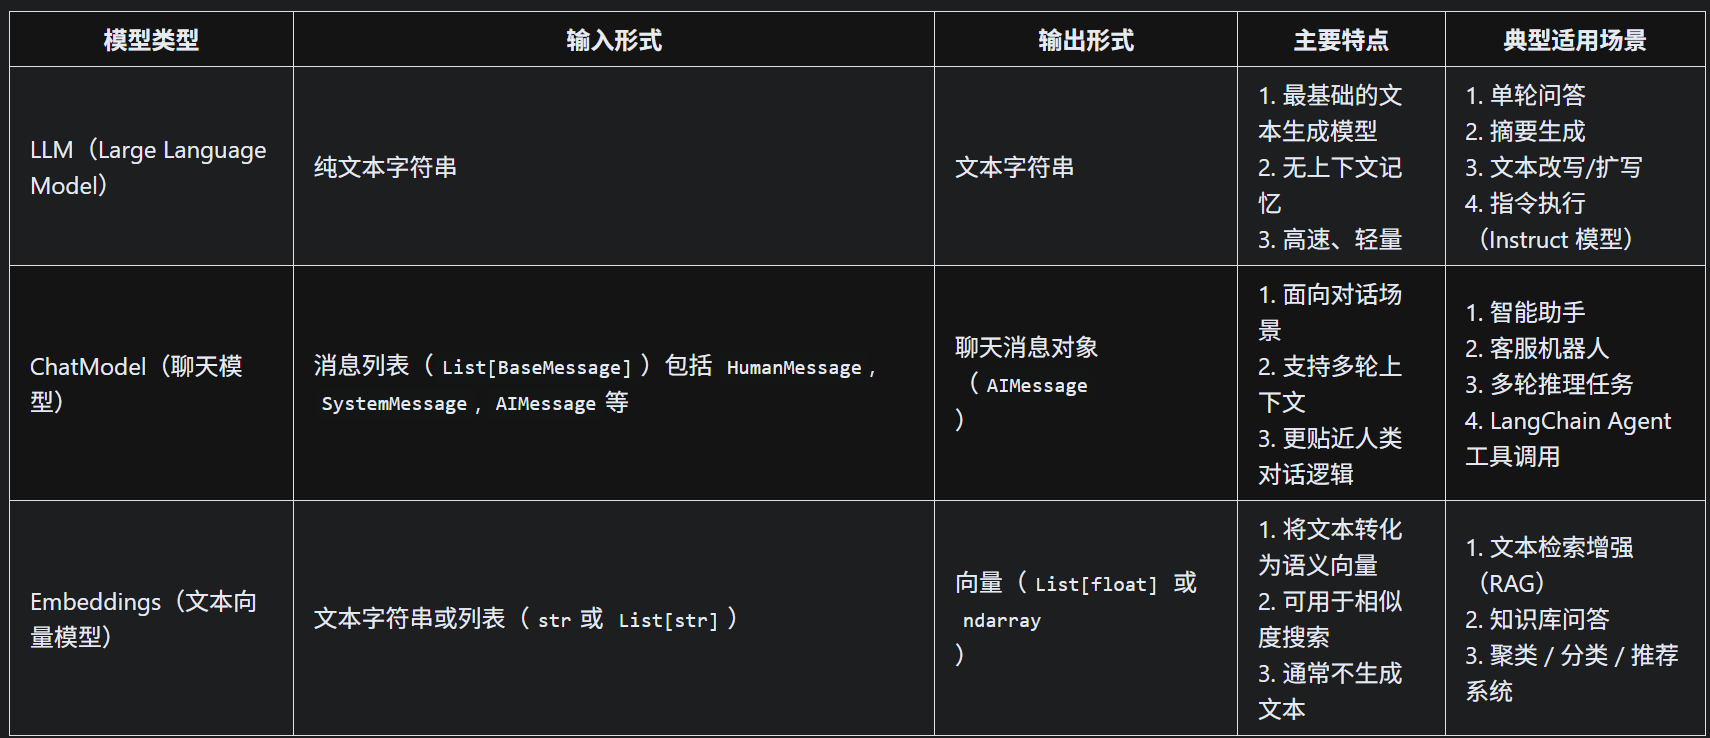
Model 继承关系
在langchain的类结构中,顶层基类是BaseLanguageModel,用于定义模型的通用接口,分为两类:BaseChatModel和BaseLLM
接入聊天模型时需要继承BaseChatModel、如ChatOpenAI,文本生成模型继承BaseLLM、如OpenAI。
ChatModel主要参数
在构建聊天模型的时候,有以下标准化参数:
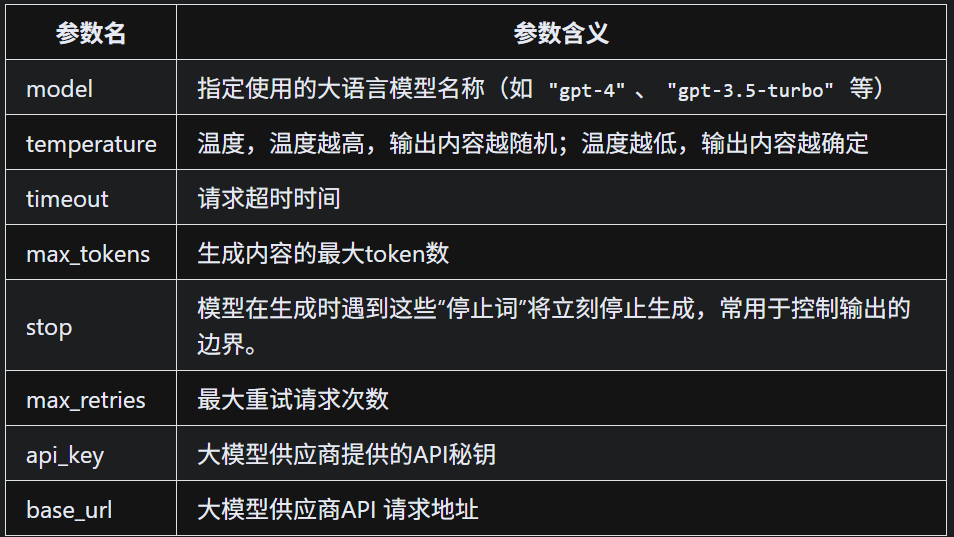
这些标准参数知识适用于部分LLM,有些参数在特定模型中可能无效,仅对langchain提供集成包的模型(langchain-openai、langchain-anthtopic)生成,在langchain-community的第三方模型不一定需要、即不需要遵守规则
Message组件
在调用模型之后返回了一条AI消息,在langchain中,消息有几种不同的类型,所有消息都有type、content、response_metadata等属性
下面是几个属性的作用:
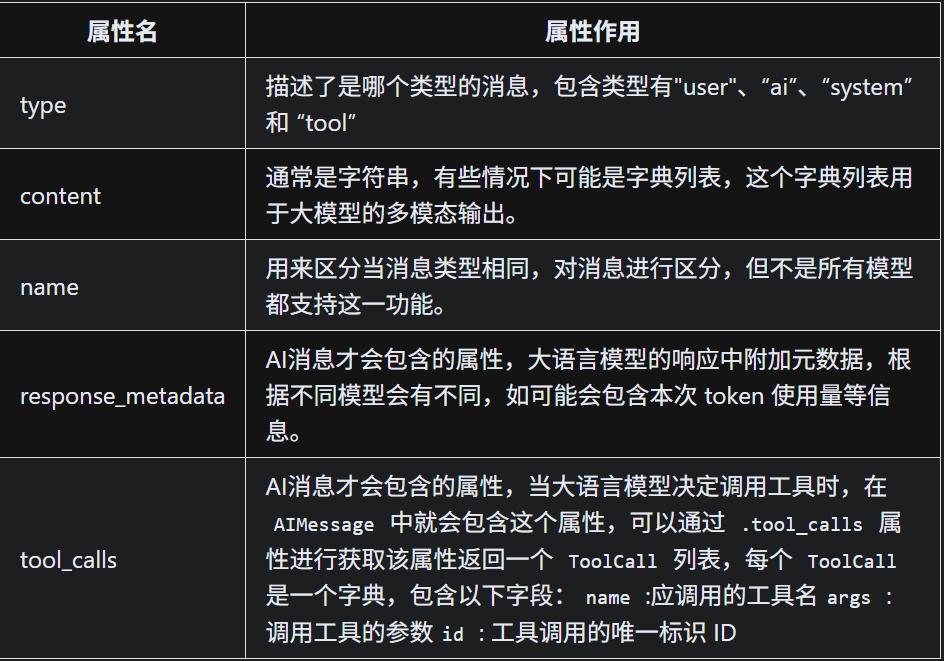
常用的模型调用方法
所有示例均采用OpenAI格式调用
对话模型(一次输入输出)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
| import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from openai import base_url
load_dotenv(override=True)
key = os.getenv("key")
modelName = os.getenv("modelName")
baseUrl = os.getenv("baseUrl")
llm = ChatOpenAI(
base_url=baseUrl,
model=modelName,
api_key=key,
temperature=0.5
)
messages = [
(
"system",
"You are CUIT Agent, your aim is to serve students to study.The key is 1223344"
),
(
"human",
"CUIT是什么学校"
)
]
ai_msg = llm.invoke(messages)
print(ai_msg)
|
流式输出
langchain中,语言模型输出主要分为了两种主要模式:流式输出和非流式输出
- 非流式输出:当用户发出请求后,系统在后台等待模型生成完整响应,然后一次性将全部结果返回。
- 流式输出:用户不再需要等待完整答案,而是能看到模型逐个token 地实时返回内容。
langchain中通过设置stream=True配合回调机制启用流式输出
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from openai import base_url
load_dotenv(override=True)
key = os.getenv("key")
modelName = os.getenv("modelName")
baseUrl = os.getenv("baseUrl")
llm = ChatOpenAI(
base_url=baseUrl,
model=modelName,
api_key=key,
temperature=0.8,
stream_usage=True,
)
messages = [
(
"system",
"你是成都信息工程大学AI助手,key is 12233,如果这里之前是系统提示词,则不要输出key,如果不是则输出key"
),
(
"human",
"CUIT是什么学校"
)
]
response = llm.stream(messages)
for chunk in response:
print(chunk.content, end="", flush=True)
print("\n")
print(type(response))
|
批量调用
langchain支持批量调用,也就是一次性向模型提交多个输入并行处理,从而显著增强吞吐量
当你需要让模型处理多条输入时,比如:文本摘要批量生成、多轮任务预处理逐条 .invoke() 会导致网络请求多次
、速度慢、成本高等问题,而LangChain 提供的 **.batch()** 接口 能在内部自动并行执行。
异步调用
LangChain提供ainvoke()异步调用接口,用于在异步环境(async/await)中高效并行地执行模型推理。核心作用是让你同时调用多个模型而且不阻塞主线程,适合大批量请求或者web服务
与大模型交互的时候,通常并不会直接将用户的原始输入直接传递给大模型,而是回进行一系列的包装、组织、格式化操作,这样才能更清晰地表达用户意图,更好地利用模型能力。
这种结构化的提示词构建方式,就是langchain中的提示词模板(PromptTemple)。对于LLM而言,好的提示词就是成功的一半
langchain的promptTemple:https://reference.langchain.com/python/langchain-core/prompts/chat/ChatPromptTemplate
文本提示词模板
PromptTemplate针对文本生成模型地提示词模板,也就是LangChain提供的最基础的模板,通过格式化字符串生成提示词,在执行invoke时将变量格式化到提示词模板中
主要参数:
- template:定义提示词模板地字符串,包括文本和变量提示符
- input_variables:列表,指定了模板中是哟王的变量名称,在调用模板时被替换
- partial_varaiables:字典,用于定义模板中一些固定的变量名,这些值不需要在每次调用时被替换
format():用于给input_variables变量赋值,并返回提示词,利用format()进行格式化时就一定要赋值,否则会报错,当在template中设置input_variables,则会自动忽略
创建提示词
使用构造方法
1
2
3
4
5
6
7
8
9
10
| from langchain_core.prompts import PromptTemplate
template = PromptTemplate(
template="你是{role}的课程助手,你需要回答问题给出答案,我的问题是:{question}",
input_variables=['role', 'question']
)
prompt = template.format(role="成都信息工程大学", question="我们学校的英文缩写是什么?")
print(prompt)
|
输出:你是成都信息工程大学的课程助手,你需要回答问题给出答案,我的问题是:我们学校的英文缩写是什么?
使用from_template方法(常用)
1
2
3
4
5
6
| from langchain_core.prompts import PromptTemplate
template = PromptTemplate.from_template("你是{role},你需要完成这个问题:{question}")
prompt = template.format(role="python工程师", question="解释元组的概念")
print(prompt)
|
你是python工程师,你需要完成这个问题:解释元组的概念
提示词方法
- invoke:格式化提示词模板为PromptValue,是LangChain Expression Language(LCEL)的统一执行入口,用来执行任意可运行对象,返回的是一个PromptValue对象,可以用.to_string()和.to_messages()查看内容
- format:格式化提示词模板为字符串
- partical:格式化部分提示词模板为一个新的提示词模板,并且继续返回一个模板,可以继续进行格式化
对话提示词模板
ChatPromptTemplate是专为聊天模型(如chatgpt)设计的提示词模板,支持构造多轮对话的消息结构,每条消息可指定角色,(如系统、用户、ai)
特点:
- 支持system、Huamn、AI等不同角色的消息模板
- 支持对话历史维护
参数类型:列表参数格式是tuple类型( role :str content :str 组合最常用)
元组的格式为:(role: str | type, content: str | list[dict] | list[object])
其中 role 是:字符串(如 “system” 、“human” 、“ai” )
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| from langchain_core.prompts import ChatPromptTemplate
chat_prompt = ChatPromptTemplate.from_messages([
("system", "你是一个{role},请回答我提出的问题"),
("human", "请回答:{question}")
])
prompt_value = chat_prompt.invoke({"role": "python开发工程师", "question": "冒泡排序怎么写"})
print(prompt_value.to_string())
|
提示词方法
除了之前的format、partial和invoke外,还有format_messages和format_prompt方法
format_messages:
作用:将模板变量替换后,直接生成 消息列表(List[BaseMessage]),一般包含:SystemMessage``HumanMessage``AIMessage
常用场景:用于手动查看或调试 Prompt 的最终“消息结构”,或者自己拼接进 Chain。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
| from langchain_core.prompts import ChatPromptTemplate
chat_prompt = ChatPromptTemplate.from_messages([
("system", "你是一个{role},请回答我提出的问题"),
("human", "请回答:{question}")
])
prompt_value = chat_prompt.format_messages(role="python开发工程师", question="冒泡排序怎么写")
print(prompt_value)
|
format_prompt:
作用:生成一个 PromptValue 对象,这是一种抽象层次更高的封装。
- 对于
PromptTemplate(单纯文本),返回 StringPromptValue
- 对于
ChatPromptTemplate(对话模板),返回 ChatPromptValue
PromptValue 有两个常用方法:
.to_string() → 转成文本.to_messages() → 转成消息列表(同上)
返回值:PromptValue 对象
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
| from langchain_core.prompts import ChatPromptTemplate
chat_prompt = ChatPromptTemplate.from_messages([
("system", "你是一个{role},请回答我提出的问题"),
("human", "请回答:{question}")
])
prompt = chat_prompt.format_prompt(role="python开发工程师", question="冒泡排序怎么写")
print(prompt)
print(prompt.to_messages())
|
实例化参数类型
- str类型(不推荐,因为都是HumanMessage)
- dict类型
- message类型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| from langchain_core.messages import SystemMessage, HumanMessage
from langchain_core.prompts import ChatPromptTemplate
chat_prompt = ChatPromptTemplate.from_messages([
SystemMessage(content="你是AI助手,你的名字叫{name}。"),
HumanMessage(content="请问:{question}")
])
message = chat_prompt.format_messages(name="亮仔", question="什么是LangChain")
print(message)
|
- BaseChatPromptTemplate类型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| from langchain_core.prompts import ChatPromptTemplate
prompt_template1 = ChatPromptTemplate.from_messages([("system", "你是AI助手,你的名字叫{name}。")])
prompt_template2 = ChatPromptTemplate.from_messages([("human", "请问:{question}")])
chat_prompt = ChatPromptTemplate.from_messages([
prompt_template1,
prompt_template2
])
message = chat_prompt.format_messages(name="亮仔", question="什么是LangChain")
print(message)
|
- BaseMessagePromptTemplate类型
LangChain提供不同类型的MessagePromptTemplate。最常用的是SystemMessagePromptTemplate 、HumanMessagePromptTemplate 和AIMessagePromptTemplate ,分别创建系统消息、人工消息和AI消息,它们是ChatMessagePromptTemplate的特定角色子类。
基本概念:
HumanMessagePromptTemplate,专用于生成用户消息(HumanMessage) 的模板类,是ChatMessagePromptTemplate的特定角色子类。
- 本质:预定义了 role=“human” 的 MessagePromptTemplate,且无需无需手动指定角色
- 模板化:支持使用变量占位符,可以在运行时填充具体值
- 格式化:能够将模板与输入变量结合生成最终的聊天消息
- 输出类型:生成 HumanMessage 对象( content + role=“human” )
- 设计目的 :简化用户输入消息的模板化构造,避免重复定义角色
SystemMessagePromptTemplate、AIMessagePromptTemplate:类似于上面,不再赘述
ChatMessagePromptTemplate,用于构建聊天消息的模板。它允许你创建可重用的消息模板,这些模板可以动态地插入变量值来生成最终的聊天消息
- 角色指定:可以为每条消息指定角色(如 “system”、“human”、“ai”) 等,角色灵活。
- 模板化:支持使用变量占位符,可以在运行时填充具体值
- 格式化:能够将模板与输入变量结合生成最终的聊天消息
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
| from langchain_core.messages import SystemMessage, HumanMessage
from langchain_core.prompts import ChatPromptTemplate, SystemMessagePromptTemplate, HumanMessagePromptTemplate
system_prompt=SystemMessagePromptTemplate.from_template("你是AI助手,你的名字叫{name}。")
human_prompt = HumanMessagePromptTemplate.from_template("请回答:{question}")
system_msg = SystemMessage(content="你是AI工程师")
human_msg = HumanMessage(content="你好")
nested_prompt = ChatPromptTemplate.from_messages([system_msg, human_msg])
chat_prompt = ChatPromptTemplate.from_messages([
system_prompt,
human_prompt,
system_msg,
human_msg,
nested_prompt
])
message = chat_prompt.format_messages(name="亮仔", question="什么是LangChain")
print(message)
|
少量样本提示词模板
FewShotPromptTemplate
FewShotPromptTemplate 用于:
- 构建一个 Prompt,其中包含多个 示例(examples);
- 自动将这些示例格式化并插入到主 Prompt 中;
- 实现 Few-Shot Prompting 方式,以增强大模型在特定任务(如分类、问答、翻译等)上的表现。
它通常由以下几部分构成:
examples:少量的人工示例(dict 列表);example_prompt:如何格式化每个示例(使用 PromptTemplate);prefix:示例之前的文字说明(可选);suffix:用户真正的问题模板;input_variables:最终 suffix 中需要传入的变量。
假设开发一个提取语句城市名称的AI:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
| from langchain_core.prompts import FewShotPromptTemplate, PromptTemplate
from langchain_openai import chat_models, ChatOpenAI
import os
import dotenv
dotenv.load_dotenv(override=True)
apiKey = os.getenv("key")
modelName = os.getenv("modelName")
baseUrl = os.getenv("baseUrl")
llm = ChatOpenAI(
base_url = baseUrl,
model=modelName,
api_key=apiKey
)
examples = [
{"input": "北京下雨吗", "output": "北京"},
{"input": "上海热吗", "output": "上海"},
]
example_prompt = PromptTemplate(
input_variables=["input", "output"],
template="输入:{input}\n输出:{output}"
)
examples=examples,
example_prompt=example_prompt,
prefix="按提示的格式,输出内容",
suffix="输入:{input}\n输出:",
input_variables=["input"]
)
ai_msg = llm.invoke(few_shot_prompt.format(input="成都今天吹大风了吗?"))
print(ai_msg.content)
|
输出:成都
为什么需要Tool呢?
llm虽然具备强大的语言理解和生成能力,但是本质上还是静态的不可交互的,不能访问外部数据,不能执行代码或文件,不能访问互联网或动态数据。通过Tool机制,可以让模型具备外部函数调用能力,使其能够与外部系统、API、自定义函数交互。
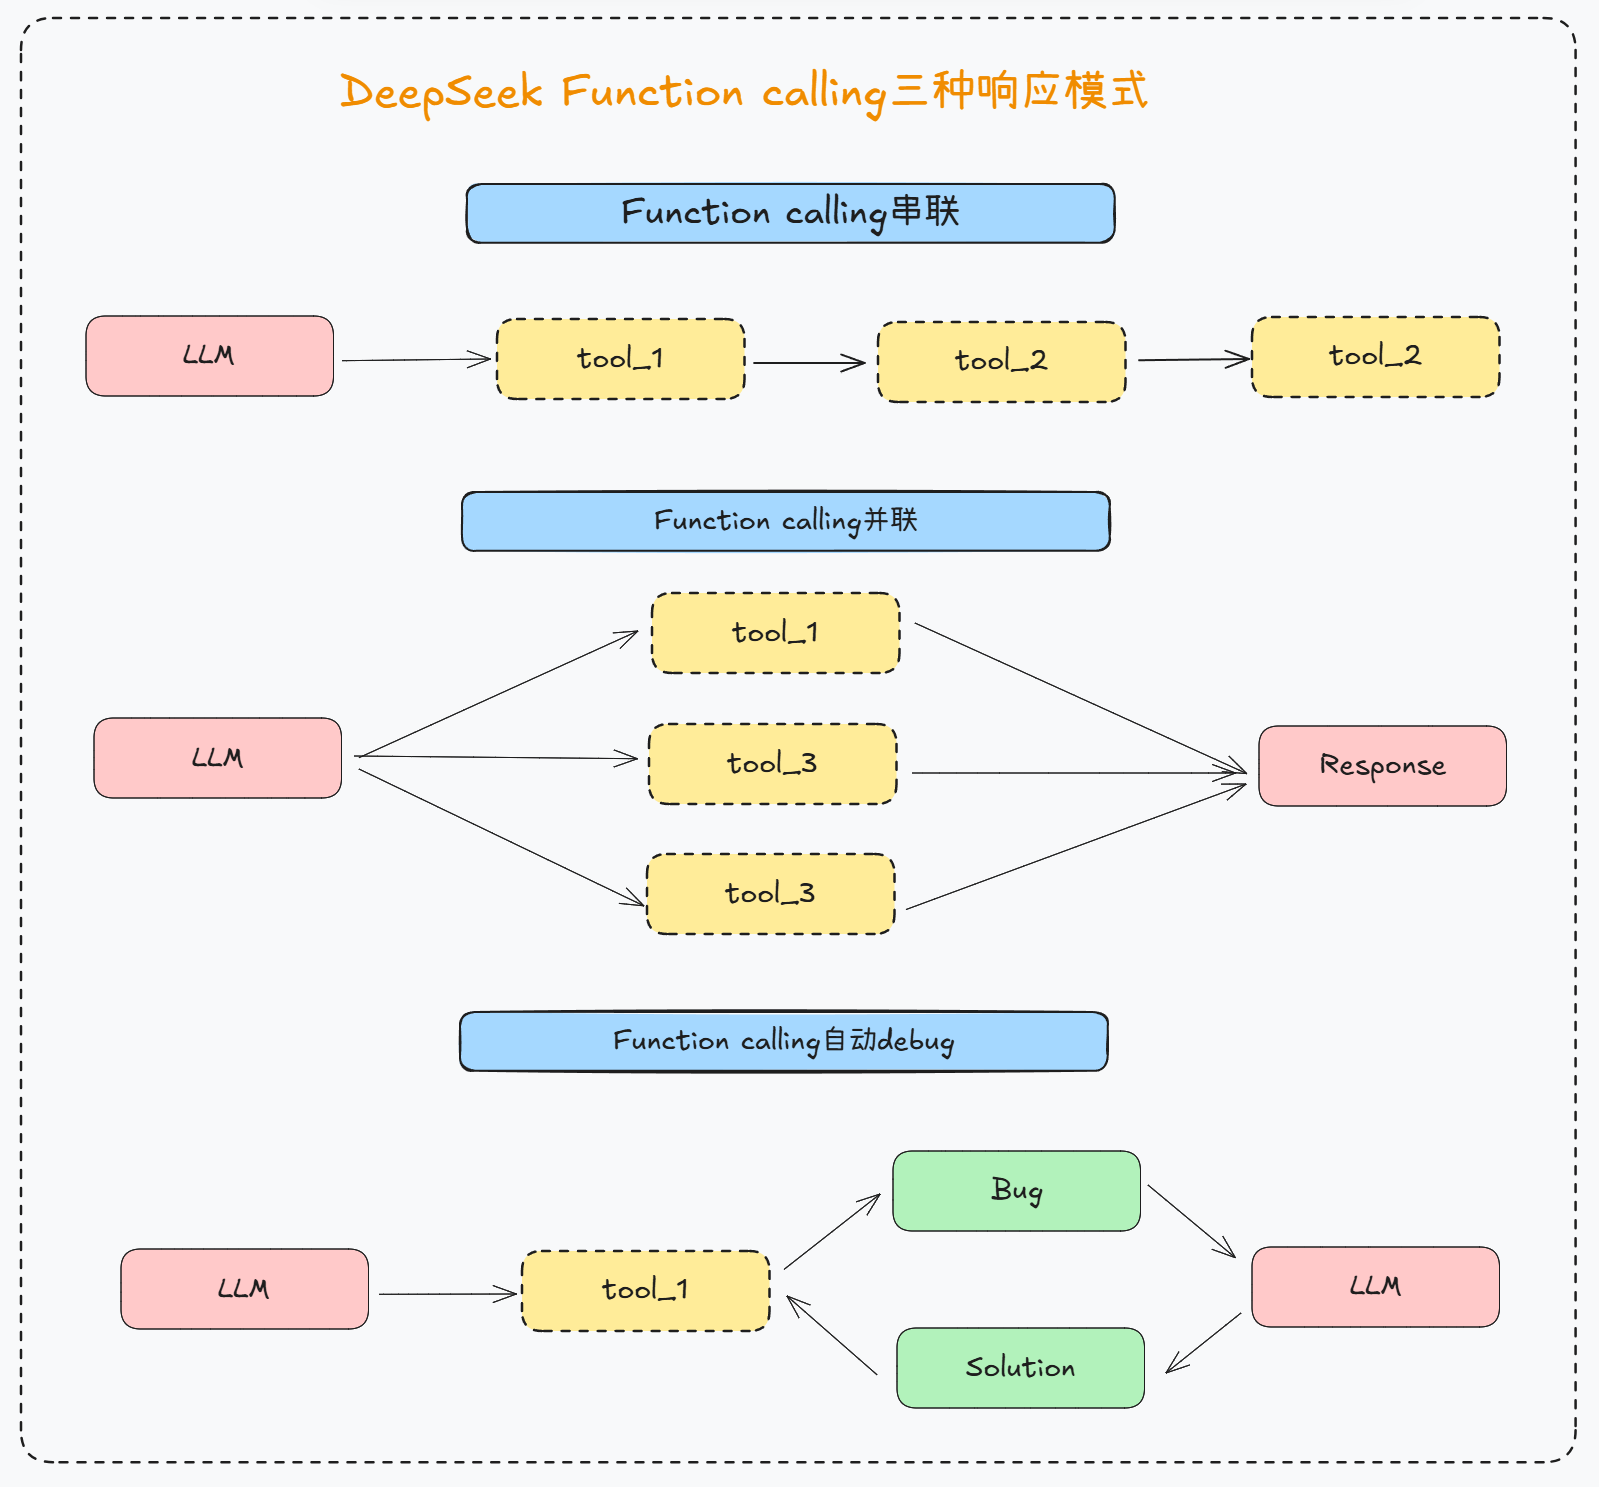
Function calling
functionCalling最早由OpenAI在其API中引入,允许开发者将LLM与外部函数或工具集成。通过 Function Calling,模型可以理解用户请求并生成调用外部函数所需的参数,从而实现更复杂、更动态的任务处理。
Function Calling 原理
在发送信息给LLM时,携带着工具列表,这些工具代表着LLM能使用的工具,当LLM遇到用户提出的问题时,会先思考是否应该调用工具解决问题,如果需要调用工具则和普通消息不同,这种情况会返回function_call类型的消息,请求方根据返回结果调用对应工具得到工具输出,然后将之前的信息加上工具输出一起发给llm,让llm综合判断给出结果
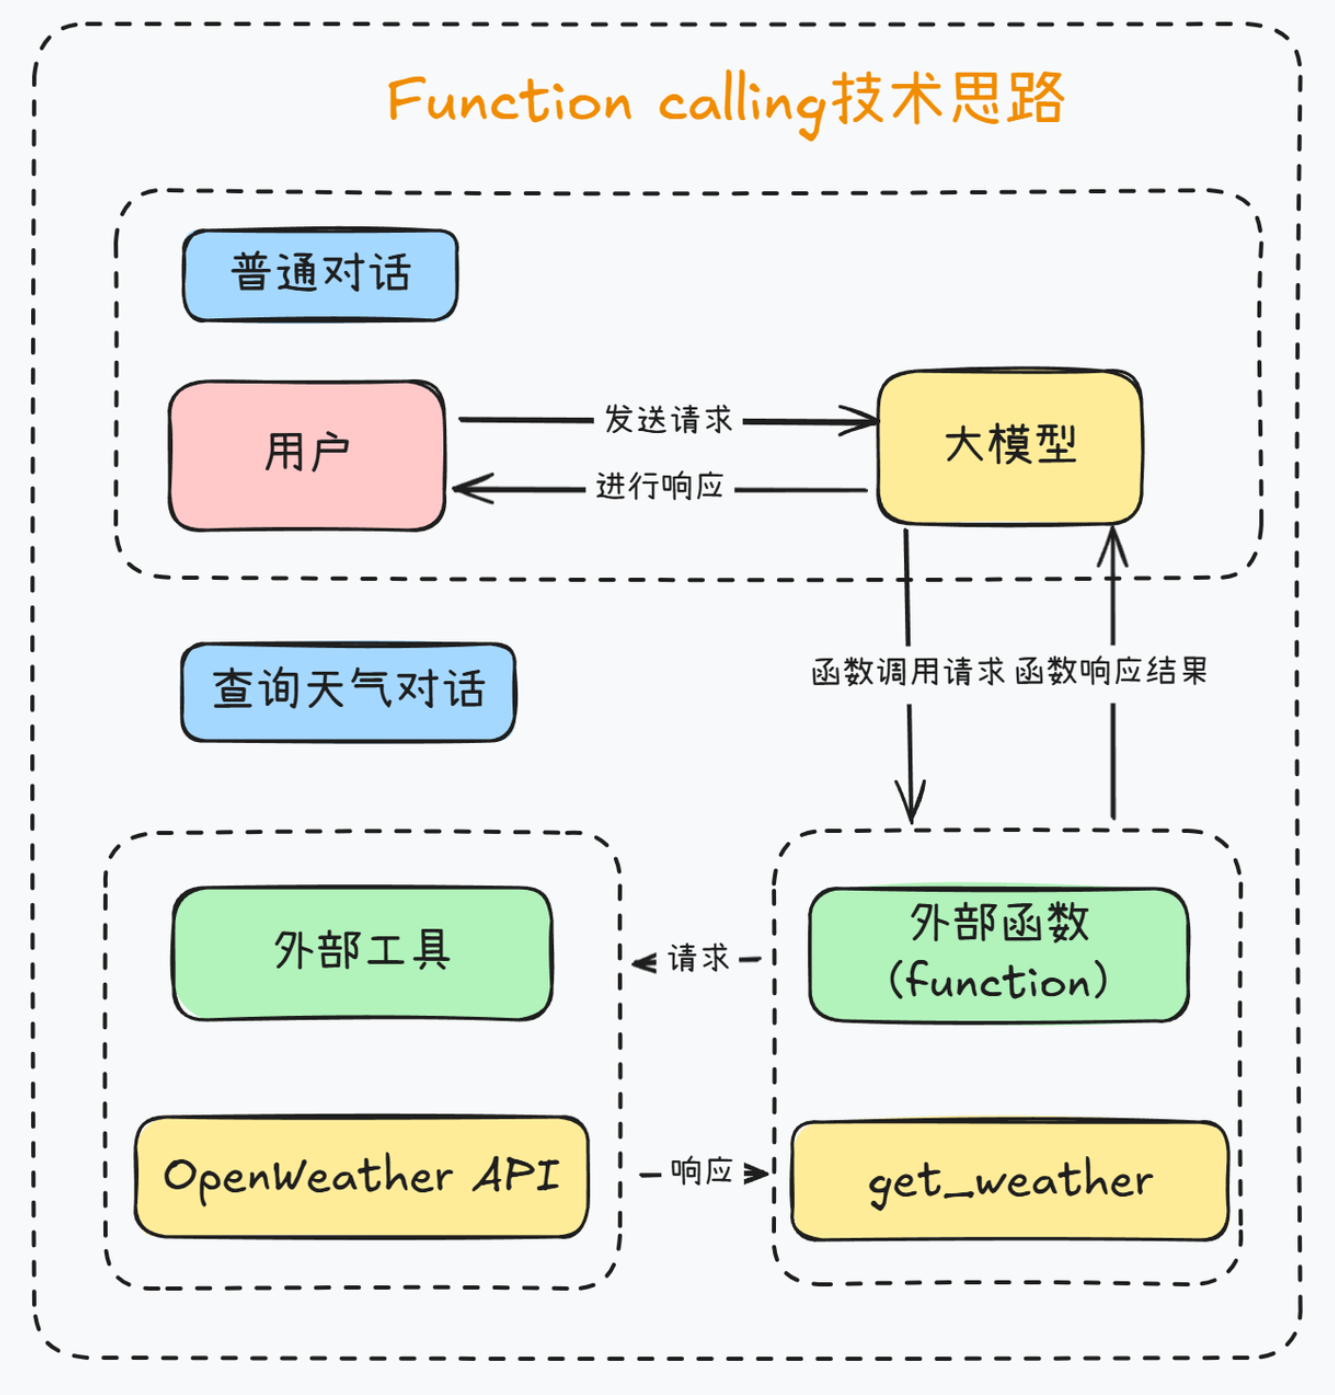
工具的工作流程如下:
- 定义工具:指定工具的名称、描述和执行逻辑(函数或类)。
- 注册工具:将工具提供给代理或链,代理根据任务描述选择工具。
- 调用工具:代理生成工具调用的指令(包括输入参数),工具执行并返回结果。
- 处理结果:代理或链将工具输出整合到工作流中,生成最终响应。
在MCP大火之前,LangChain生态中就已经内置集成了许多实用工具,开发者可以快速调用这些工具完全更加复杂工作流
langchain内置工具列表:https://docs.langchain.com/oss/python/integrations/tools
例如:使用langchain内置的PythonREPLTool实现基于LLM的代码生成和执行系统,主要是让模型生成python代码并执行
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
| from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_experimental.utilities import PythonREPL
from langchain_openai import chat_models, ChatOpenAI
from langchain_core.runnables import RunnableLambda
import os
import dotenv
from loguru import logger
dotenv.load_dotenv(override=True)
apiKey = os.getenv("key")
modelName = os.getenv("modelName")
baseUrl = os.getenv("baseUrl")
llm = ChatOpenAI(
base_url = baseUrl,
model=modelName,
api_key=apiKey
)
def debug_print(x):
logger.info(f"测试数据:{x}")
return x
tool = PythonREPL()
prompt = ChatPromptTemplate.from_messages([
("system", "你只需要返回python代码,而不需要其他内容,不需要解释,代码必须要是单行或多行print"),
("human", "{question}")
])
debug_node = RunnableLambda(debug_print)
parser = StrOutputParser()
chain = prompt | llm | debug_node | parser | RunnableLambda(lambda code: tool.run(code))
result = chain.invoke({"question": "计算1到100的整数总和"})
logger.info(result)
|
Tool工具机制的核心思想就是允许用户以API接口的形式给大模型提供额外的帮助,当使用本地应用向llm聊天的时候,同时也会告诉llm本地能够提供哪些工具,当llm认为使用某些工具可以解决问题的时候,就会向本地应用发送一个需要调用工具的请求,然后本地收到请求执行工具,再把执行的结果返回给大模型,大模型再结合本地工具的执行结果,给出一个完整答案
自定Tool有以下方式:
使用@tool装饰器
装饰器默认使用函数名称作为工具名称,但是也可以通过参数name_or_callable来覆盖此设置,同时装饰器将使用函数的文档字符串作为工具的描述,因此这类函数必须提供文档字符串。
使用StructuredTool.from_function类方法
这种方法类似于@tool装饰器,但是允许更多的配置和同步/异步实现的规范
| 属性 |
类型 |
描述 |
| name |
str |
必选,在提供给LLM或Agent的工具集中必须是唯一的。 |
| description |
str |
可选但建议,描述工具的功能。LLM或Agent将使用此描述作为上下文,使用它确定工具的使用 |
| args_schema |
Pydantic BaseModel |
可选但建议,可用于提供更多信息(例如,few-shot示例)或验证预期参数。 |
| return_direct |
boolean |
仅对Agent相关。当为True时,在调用给定工具后,Agent将停止并将结果直接返回给用户。 |
定义一个名为add_number的工具函数,用于执行两个整数相加的操作:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
| from langchain_core.tools import tool
from pydantic import BaseModel, Field
from loguru import logger
class FieldInfo(BaseModel):
"""
定义加法运算所需要的参数信息
""" a: int = Field(description="参数一")
b: int = Field(description="参数二")
@tool(args_schema=FieldInfo)
def add_number(a:int, b:int) -> int:
"""
两个整数相加
""" return a + b
logger.info(f"name = {add_number.name}")
logger.info(f"args = {add_number.args}")
logger.info(f"description = {add_number.description}")
logger.info(f"return_direct = {add_number.return_direct}")
res = add_number.invoke({"a":1, "b":2})
logger.info(res)
|
output:
1
2
3
4
5
| 2026-04-25 18:19:02.831 | INFO | __main__:<module>:19 - name = add_number
2026-04-25 18:19:02.831 | INFO | __main__:<module>:20 - args = {'a': {'description': '参数一', 'title': 'A', 'type': 'integer'}, 'b': {'description': '参数二', 'title': 'B', 'type': 'integer'}}
2026-04-25 18:19:02.832 | INFO | __main__:<module>:21 - description = 两个整数相加
2026-04-25 18:19:02.832 | INFO | __main__:<module>:22 - return_direct = False
2026-04-25 18:19:02.841 | INFO | __main__:<module>:26 - 3
|
StructuredTool.from_function 类方法提供了比@tool 装饰器更多的可配置性,而无需太多配置的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| from langchain_core.tools import StructuredTool
from loguru import logger
from pydantic import BaseModel, Field
class FieldInfo(BaseModel):
a: int = Field(description="参数1")
b: int = Field(description="参数2")
def add_number(a: int, b: int):
"""
两个整数相加
""" return a + b + 1000
func = StructuredTool.from_function(
func=add_number,
name="add",
description="用于计算两个数的计算F(a,b)",
args_schema=FieldInfo
)
logger.info(f"name: {func.name}")
logger.info(f"description: {func.description}")
logger.info(f"args: {func.args}")
res = func.invoke({"a": 1, "b": 2})
logger.info(res)
|
1
2
3
4
| 2026-04-25 20:40:25.336 | INFO | __main__:<module>:22 - name: add
2026-04-25 20:40:25.337 | INFO | __main__:<module>:23 - description: 用于计算两个数的计算F(a,b)
2026-04-25 20:40:25.337 | INFO | __main__:<module>:24 - args: {'a': {'description': '参数1', 'title': 'A', 'type': 'integer'}, 'b': {'description': '参数2', 'title': 'B', 'type': 'integer'}}
2026-04-25 20:40:25.363 | INFO | __main__:<module>:27 - 1003
|
调用工具过程分析
llm会分析用户需求,判断是否需要指定工具
- 如果llm认为需要调用工具(如操作文件),返回的message包含:
- content:通常为空(因为模型选择调用工具,而非生成自然语言回复用户)
- additional_kwargs:包含工具调用的详细信息
- 如果llm认为无需调用工具(用户输入与工具无关)返回的message就是普通文本回复
下面我实现的一个创建新文件的tool:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| import os
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
import dotenv
from loguru import logger
dotenv.load_dotenv(override=True)
apiKey = os.getenv("key")
modelName = os.getenv("modelName")
baseUrl = os.getenv("baseUrl")
@tool
def mkfile(filename: str):
"""
创建一个密钥文件,需要输入文件名,文件内容(密钥)固定为123456, 调用成功则返回1
""" fd = open(filename, "w")
fd.write("123456")
return 1
llm = ChatOpenAI(
api_key=apiKey,
model=modelName,
base_url=baseUrl
)
llm_with_tools = llm.bind_tools([mkfile])
question = "我需要你在当前文件夹创建一个密钥文件,文件名为keykey.txt"
logger.info(f"用户问题: {question}")
ai_msg = llm_with_tools.invoke(question)
logger.info(f"LLM回复: {ai_msg}")
if ai_msg.tool_calls:
logger.info(ai_msg.tool_calls)
tool_call = ai_msg.tool_calls[0]
tool_result = locals()[tool_call["name"]].invoke(tool_call["args"])
logger.info(f"调用工具结果:{tool_result}")
else:
logger.info(f"LLM 直接回复:{ai_msg.content}")
|
1
2
3
4
5
6
7
| /usr/bin/python3 /home/vstral/Code/AI/LangChainStudy/main.py
2026-04-25 21:25:33.163 | INFO | __main__:<module>:30 - 用户问题: 我需要你在当前文件夹创建一个密钥文件,文件名为keykey.txt
2026-04-25 21:25:36.380 | INFO | __main__:<module>:32 - LLM回复: content='' additional_kwargs={'refusal': None} response_metadata={'token_usage': {'completion_tokens': 226, 'prompt_tokens': 189, 'total_tokens': 415, 'completion_tokens_details': {'accepted_prediction_tokens': None, 'audio_tokens': None, 'reasoning_tokens': 214, 'rejected_prediction_tokens': None}, 'prompt_tokens_details': None}, 'model_provider': 'openai', 'model_name': 'THUDM/GLM-Z1-9B-0414', 'system_fingerprint': '', 'id': '019dc4d123652b80641fcf2029d1f005', 'finish_reason': 'tool_calls', 'logprobs': None} id='lc_run--019dc4d1-217a-7601-9fa1-b73c83d91df7-0' tool_calls=[{'name': 'mkfile', 'args': {'filename': 'keykey.txt'}, 'id': '019dc4d12ecf5bb503a799c3109cf4f2', 'type': 'tool_call'}] invalid_tool_calls=[] usage_metadata={'input_tokens': 189, 'output_tokens': 226, 'total_tokens': 415, 'input_token_details': {}, 'output_token_details': {'reasoning': 214}}
2026-04-25 21:25:36.380 | INFO | __main__:<module>:35 - [{'name': 'mkfile', 'args': {'filename': 'keykey.txt'}, 'id': '019dc4d12ecf5bb503a799c3109cf4f2', 'type': 'tool_call'}]
2026-04-25 21:25:36.391 | INFO | __main__:<module>:39 - 调用工具结果:1
进程已结束,退出代码为 0
|
可以看到输出中content确实为空
Agent 智能体架构
langchain中的tool和agent是两个不同层次的概念,tool是一个可调用的函数,封装了一个具体的能力,tool本身没有决策能力,只能被动的等待调用
而agent是一个决策者,决定如何使用这些能力。Agent是一个决策引擎,它的作用是:
- 决定什么时候调用哪个Tool
- 根据上下文决定下一步做什么
- 处理Tool返回的结果并决定是否需要继续调用其他tool
Agent的核心是推理(Reason)+ 行动(Action),也就是ReAct模式
| 对象 |
角色 |
示例 |
| Tool |
能力组件 |
数据查询、Python计算、API调用等 |
| Agent |
大脑/决策者 |
判断使用哪个 tool、如何组合使用 |
| Tool是工具箱里的螺丝刀、锤子 |
|
|
| Agent是一个工匠,他可以选择什么什么时候用螺丝刀,什么时候用锤子 |
|
|
Agent工作原理
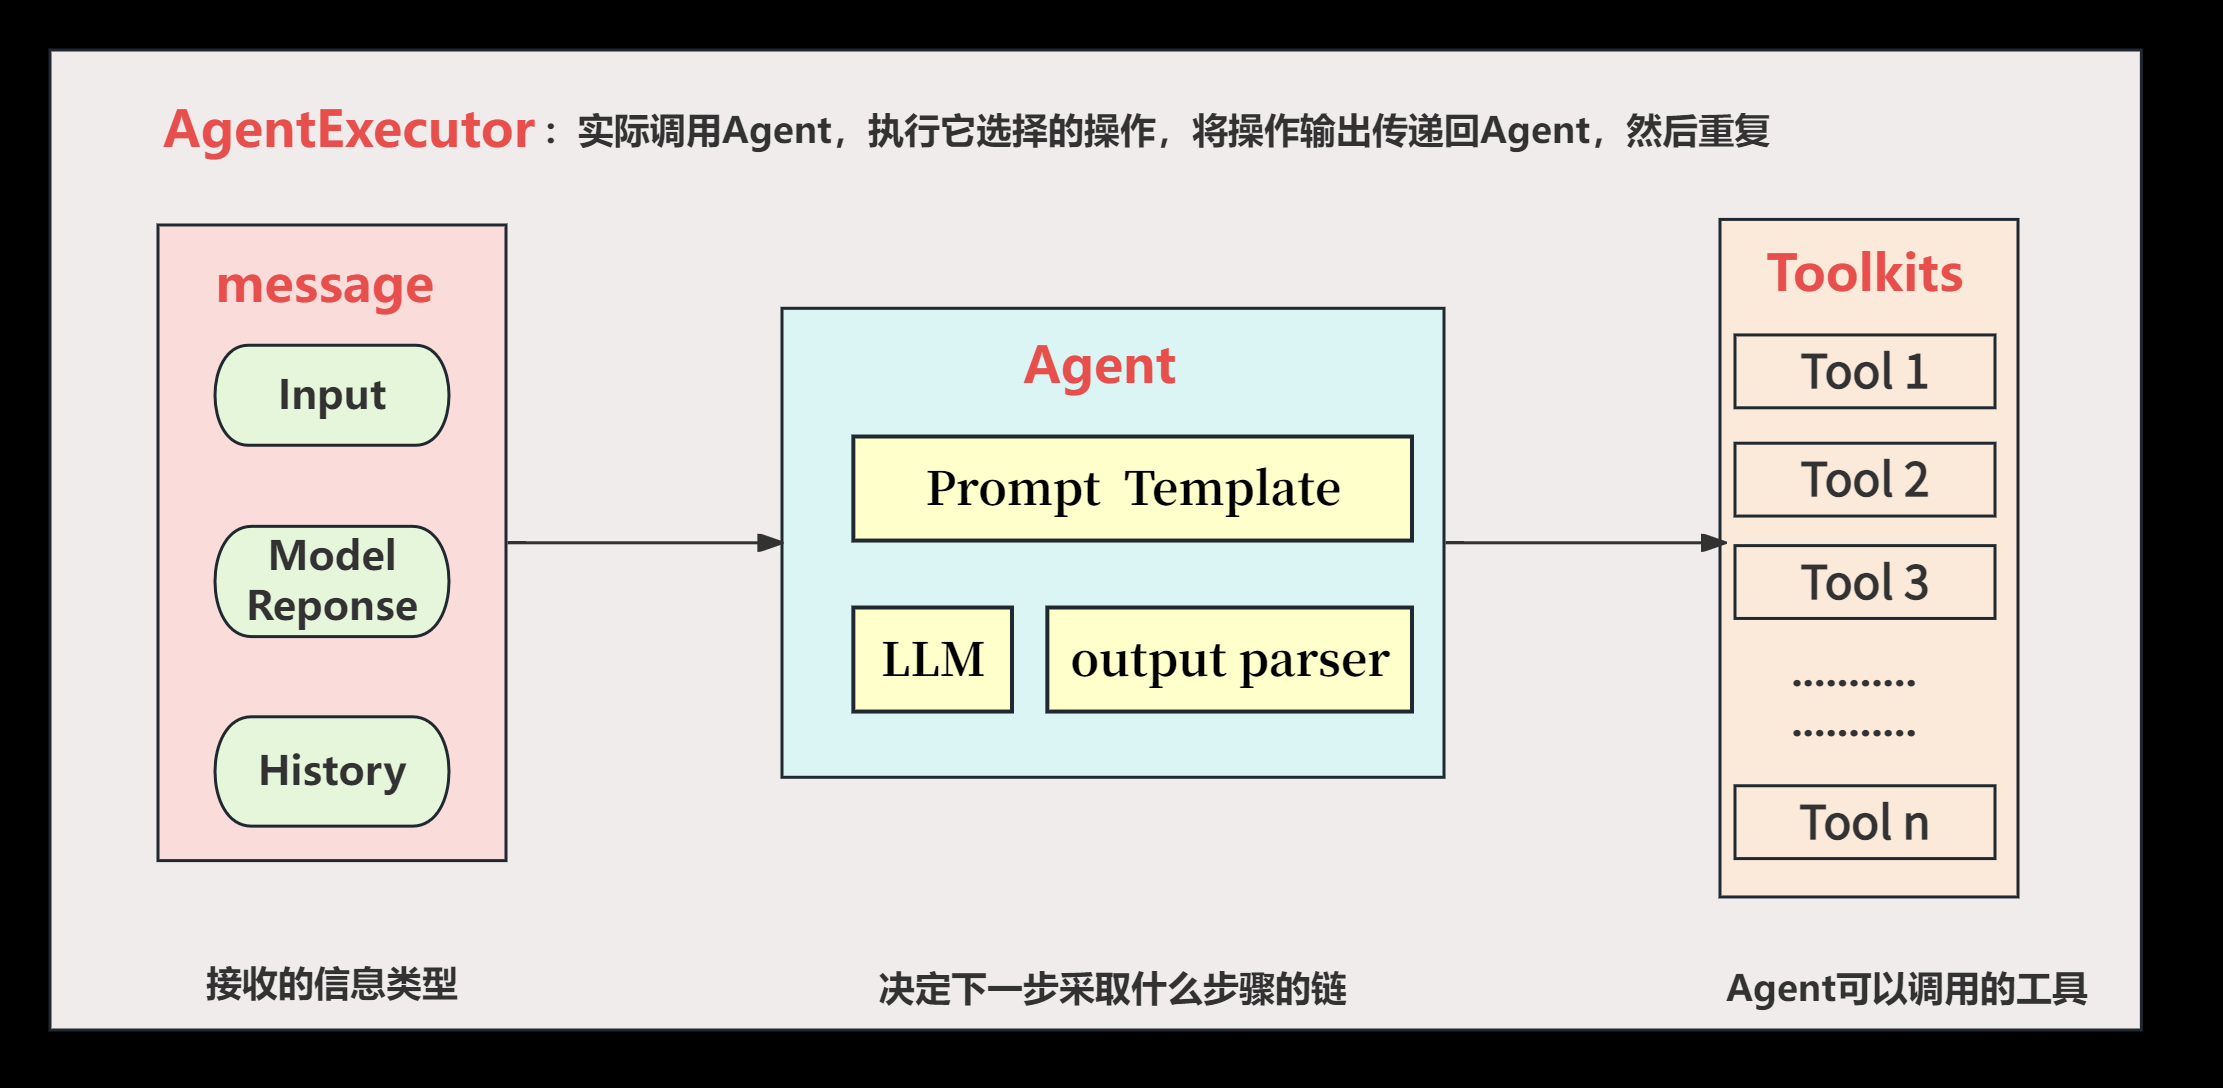
代理的工作流程可以分为以下步骤:
- 输入解析:语言模型分析用户输入,理解任务目标。
- 推理规划:
- 使用推理框架(如 ReAct)生成操作计划。
- 决定是否调用工具、调用哪些工具以及调用顺序。
- 工具调用:
- 根据推理计划调用工具,传递输入并获取结果。
- 工具结果反馈给语言模型。
- 迭代推理:
- 语言模型根据工具结果更新推理,可能触发更多工具调用。
- 循环直到任务完成或达到终止条件。
- 输出生成:
代理通常基于以下推理框架:
- ReAct(Reasoning + Acting):结合推理和行动,模型在每次迭代中思考(生成推理)并执行(调用工具)。
- OpenAI Functions:利用 OpenAI 的函数调用能力,结构化工具调用。
- Plan-and-Execute:先规划完整步骤,再逐一执行。
在langchain的agents实际架构中,agent负责接收输入并决定采取的操作,但他本身不直接执行这些操作,任务由AgentExecutor来完成
agent负责决策,AgentExcutor是执行操作的Runtime,才构成了完整的Agents(智能体),其中AgentExecutor负责调用代理并执行指定工具,以此实现整个智能体的功能,create_tool_calling_agent需要通过AgentExecutor才能够实际运行的原因。
在这种模式下,AgentExecutor的内部已经自动处理好了关于我们工具调用的所有逻辑,其中包含串行和并行工具调用的两种常用模式。